Dans « IA hybride en entreprise : Cloud vs. Local, le faux débat », nous avons décrit le continuum cloud, privé, edge et endpoint, ainsi que la gouvernance qu'il exige. Les équipes qui construisent des applications web et mobiles ont maintenant une question plus pratique : pour ce cas d'usage, où le traitement doit-il s'exécuter, et pourquoi ?
Nous proposons d'y répondre en deux temps. On part du cas d'usage métier, qui fixe les données, le volume, le délai, la qualité attendue, le besoin hors ligne et le budget. On descend ensuite aux fonctionnalités de l'application, qui héritent de ces contraintes et peuvent chacune s'exécuter à un endroit différent. La token-économie et la sécurité se traitent dès cette étape de conception.
1. Partir des cas d'usage
Le besoin métier détermine l'architecture. Pour un même cas d'usage, trois emplacements sont envisageables : le terminal de l'utilisateur, l'infrastructure de l'entreprise et le cloud. La matrice ci-dessous donne des orientations de départ pour six cas courants. Elles restent des hypothèses, à vérifier sur des données représentatives et sur les équipements réellement utilisés avant de s'engager.
| Usage | Données | Volume, délai, qualité | Environnement candidat | Intérêt économique | Contraintes |
|---|---|---|---|---|---|
| Classification de tickets à fort volume | Tickets internes, parfois personnels | Volume élevé, délai court, qualité mesurable sur l'historique | Modèle compact sur infrastructure privée, ou classifieur spécialisé | Coût marginal faible si le volume occupe réellement le matériel | Comparer d'abord à une règle ou à un classifieur classique ; mesurer la qualité par catégorie |
| Extraction de documents confidentiels | Contrats, RH, finance | Volume moyen, précision prioritaire | Terminal ou infrastructure privée | Évite des transferts et des contextes longs facturés | Maîtriser journaux, accès, sauvegardes et caches ; vérifier précision et provenance des documents |
| Assistant terrain hors connexion | Procédures, données d'intervention | Réseau absent ou instable, réponse immédiate attendue | Modèle embarqué sur l'appareil | Aucun coût par appel, mais distribution des modèles et compatibilité du parc à financer | Hors ligne seulement si modèle, données et outils sont sur l'appareil ; un serveur privé distant reste dépendant du réseau |
| Recherche documentaire interne (RAG) | Base documentaire aux droits hétérogènes | Volume variable, pertinence et traçabilité attendues | RAG avec un modèle adapté, privé ou cloud selon la classification | Coût dominé par la taille du contexte injecté | Filtrer selon les droits avant l'envoi au modèle ; ne transmettre que les passages utiles |
| Analyse complexe sur données transférables | Données dont le transfert est autorisé | Faible volume, exigence de raisonnement élevée | Modèle cloud approuvé | Payer à l'usage plutôt que dimensionner du matériel rarement sollicité | Minimiser le contexte envoyé ; vérifier les conditions contractuelles du fournisseur |
| Règle métier stable | Données structurées | Résultat déterministe attendu | Code ou moteur de règles | Aucune inférence, coût quasi nul par exécution | Un modèle ajouterait du coût et de la variabilité sans bénéfice |
Pour une règle métier stable, du code suffit : toutes les tâches ne nécessitent pas un LLM, ni même un modèle d'IA. Pour les autres cas, un modèle compact n'est pas forcément assez bon et un grand modèle pas forcément nécessaire. Ce sont les mesures sur un jeu d'évaluation qui permettent de choisir.
2. Du cas d'usage aux fonctionnalités
Dans l'application, un cas d'usage se traduit par plusieurs fonctionnalités, qui n'ont pas toutes les mêmes contraintes. Dans un assistant terrain, par exemple, l'aide à la saisie peut tourner sur le téléphone, la recherche dans les procédures sur un serveur interne et l'analyse d'un incident complexe sur un modèle cloud, si les données concernées peuvent être transférées. Les trois emplacements n'offrent pas les mêmes garanties :
- Le modèle embarqué s'exécute dans le navigateur ou sur le terminal. Des environnements comme ONNX Runtime Web (WebAssembly, WebGPU, WebNN) , ONNX Runtime Mobile (Android, iOS) ou Windows ML sur les PC Windows le rendent possible, à condition que le modèle tienne dans la mémoire et le stockage de l'appareil et que ses opérateurs soient pris en charge par le moteur choisi.
- Le modèle hébergé sur une infrastructure privée s'exécute sur des serveurs contrôlés par l'entreprise ou son hébergeur. Les données restent dans ce périmètre, mais l'application doit pouvoir le joindre par le réseau.
- L'API cloud donne accès à des modèles managés, souvent plus puissants, facturés à l'usage, selon les conditions propres au fournisseur.
Un serveur interne n'apporte pas le hors-ligne sur mobile : un technicien sans réseau n'atteint pas plus le datacenter de son entreprise qu'un service cloud. L'inférence embarquée ne garantit d'ailleurs le fonctionnement hors connexion que si les données, les outils et les autres dépendances nécessaires sont aussi présents sur l'appareil.
Une fiche de décision par fonctionnalité
Pour rendre ces choix explicites et révisables, nous recommandons de consigner, pour chaque fonctionnalité, le cas d'usage dont elle relève, ainsi que :
- les utilisateurs et leurs droits ;
- la sensibilité des données traitées ;
- la fréquence et la concurrence d'usage ;
- le délai de réponse attendu ;
- la qualité minimale acceptable ;
- le besoin de fonctionnement hors ligne ;
- le budget alloué ;
- les destinations de traitement autorisées ;
- le comportement attendu en cas d'échec.
3. Token-économie : raisonner en coût complet
Les tokens mesurent la consommation des modèles de langage, mais ils ne suffisent pas à chiffrer un service. Nous retenons comme indicateur principal le coût par tâche réussie et validée, à qualité comparable. Une réponse peu chère qu'il faut reprendre deux fois revient plus cher qu'une réponse correcte du premier coup.
Ce qui consomme réellement
Pour une API facturée à l'usage, la facture dépend des tokens d'entrée (instructions, question, historique de conversation, passages documentaires injectés, définitions d'outils) et des tokens de sortie générés. S'y ajoutent souvent des coûts moins visibles : appels d'outils successifs, reprises après une réponse insuffisante, boucles d'agents qui enchaînent plusieurs appels pour une seule demande. Selon les services, le raisonnement, le cache ou les modalités audio et image sont facturés selon des conditions propres au fournisseur. Cet article ne retient aucun tarif : les grilles changent vite et se vérifient au moment du chiffrage.
Les leviers
- Traiter localement les tâches fréquentes et bornées, avec des modèles compacts spécialisés lorsque les évaluations le justifient.
- Réduire le contexte : ne transmettre que les passages pertinents, l'historique utile et les données minimales. Une recherche documentaire efficace, filtrée par les droits d'accès, réduit à la fois le coût et le risque.
- Borner l'exécution : plafonds de tokens en sortie, limites d'itérations pour les agents, délais maximaux.
- Utiliser un cache cloisonné et à jour, jamais partagé entre utilisateurs ou clients qui n'ont pas les mêmes droits.
- Fixer des quotas par utilisateur, par équipe et par fonctionnalité.
- Escalader de façon sélective vers un modèle plus puissant, selon des critères validés.
Microsoft décrit la même famille de leviers (cache, traitement par lots, routage, choix du modèle) dans son guide d'optimisation des coûts IA. Il recommande aussi de faire passer chaque changement par un jeu d'évaluation avant déploiement, pour vérifier que la baisse de coût ne s'accompagne pas d'une baisse de qualité.
Attention aux fausses économies : une synthèse produite localement avant un envoi au cloud réduit le volume transmis, mais elle ne garantit ni l'anonymisation des données ni l'absence de perte d'information.
Un exemple hypothétique
Prenons une application qui reçoit 100 000 demandes par mois. Après mise en place du routage, 60 000 sont résolues localement, 10 000 par un cache valide et 30 000 sont envoyées au cloud.
100 000
demandes par mois (hypothèse)
30 000
demandes encore envoyées au cloud
−70 %
d'appels cloud ; l'économie reste à mesurer
Par rapport à une référence où chaque demande déclenche un appel cloud, le nombre d'appels cloud baisse de 70 %. On ne peut pas en déduire 70 % d'économies. Les demandes qui restent envoyées au cloud sont souvent les plus longues et les plus complexes ; elles peuvent consommer davantage de tokens par appel. Le traitement local a lui-même un coût. Et lorsqu'une demande d'abord traitée localement est escaladée, elle génère un double appel qu'il faut compter dans les mesures réelles.
Le coût complet
Coût hybride = coût local imputé + exploitation + consommation cloud + services associés
Le coût local imputé couvre le matériel amorti ou loué (GPU, CPU, NPU), l'énergie et l'hébergement. L'exploitation recouvre l'administration, la maintenance, les mises à jour, la distribution des modèles vers les serveurs ou les terminaux et la supervision. Les services associés incluent notamment la recherche documentaire et le stockage. Chaque poste ne doit être compté qu'une fois : une supervision mutualisée, par exemple, ne doit pas apparaître à la fois dans l'exploitation et dans les services.
Coût cloud = (tokens entrants facturés ÷ 1 million × tarif entrée) + (tokens sortants facturés ÷ 1 million × tarif sortie) + autres frais applicables
Le cache, les tokens de raisonnement et les modalités multimédias suivent la grille propre à chaque fournisseur.
Les indicateurs à suivre
Au-delà du coût par tâche validée, suivez le taux de résolution locale, le nombre de tokens par tâche, le taux d'escalade, les reprises, la latence au 95e percentile (p95), la concurrence et la saturation des ressources. La saturation compte particulièrement : une infrastructure locale peu utilisée peut coûter plus cher que le cloud, parce que son coût fixe se répartit sur peu de demandes. Il n'existe pas de seuil de rentabilité universel ; il dépend de votre volume réel, de votre matériel et des tarifs en vigueur, et doit être recalculé lorsque l'un d'eux change.
4. Un arbre de décision contrôlé côté serveur
Le routage d'une demande se ramène à quelques questions, posées dans un ordre précis : on vérifie que le transfert est autorisé avant de comparer les coûts. Le traitement local fait partie des destinations autorisées et se compare aux autres sur la qualité, le délai et le coût, sans priorité de principe.
Version texte du schéma
- Une règle déterministe ou un cache autorisé suffit-il ? Si oui, réponse sans nouvelle inférence.
- Sinon, le transfert cloud est-il autorisé pour ces données, selon la politique appliquée côté serveur ?
- Si non : un traitement local ou privé adapté est-il disponible ? Si oui, inférence locale ou privée ; sinon, attente ou fonction limitée.
- Si oui : comparer les options autorisées selon la qualité, le délai et le coût, puis retenir l'inférence locale ou privée, ou un modèle cloud approuvé.
La décision de transfert relève d'une politique appliquée côté serveur, à partir de la classification des données et des droits de l'utilisateur. Un modèle de langage ne peut pas s'accorder lui-même cette autorisation. Si le traitement local est indisponible, la fonction se dégrade ou attend ; cette panne ne permet jamais d'envoyer au cloud un contenu interdit.
L'escalade vers un modèle plus puissant repose elle aussi sur des validations : contrôle de format, règles métier, score sur un jeu d'évaluation, vérification technique. La confiance que le modèle affiche dans sa propre réponse ne suffit pas.
5. Confidentialité, souveraineté, sécurité : trois questions distinctes
Ces trois notions sont souvent confondues alors qu'elles posent des questions différentes.
- Confidentialité : qui peut accéder aux prompts, aux résultats, aux documents, aux embeddings, aux caches et aux historiques ?
- Souveraineté : qui contrôle l'hébergement, l'administration, les clés de chiffrement et les dépendances ? Quelles juridictions, quels opérateurs et quels sous-traitants interviennent ?
- Sécurité : comment sont protégés les accès, les échanges, les artefacts de modèles et les actions déclenchées ?
Un hébergement en France ou en Europe ne suffit pas, à lui seul, à démontrer la souveraineté. Il faut aussi examiner les opérateurs et les administrateurs, la gestion des clés, les sous-traitants, la rétention, les sauvegardes, la télémétrie et les services annexes. Les conditions contractuelles se vérifient fournisseur par fournisseur ; aucune conformité n'est automatique.
Deux raccourcis à éviter : « local = sécurisé » et « cloud = non sécurisé ». Un serveur interne mal configuré peut exposer davantage qu'un service cloud bien contractualisé et bien administré, et un service cloud mal encadré peut exposer davantage qu'un serveur interne bien tenu.
6. Sécuriser la chaîne complète
Une fonctionnalité IA traverse plusieurs maillons, chacun avec ses propres contrôles.
- Application et backend : authentification des utilisateurs, autorisations par fonction et par ressource, validation des entrées, quotas, délais et limites de taille.
- Backend et inférence : chiffrement TLS des échanges, identité de service pour appeler les modèles, réseau privé ou authentification mutuelle selon le niveau de risque, liste des destinations autorisées, secrets conservés côté serveur et renouvelés selon la politique en vigueur.
- Données et RAG : droits d'accès appliqués avant la restitution documentaire, séparation stricte entre clients, minimisation du contexte, contrôle des caches et de leur invalidation.
- Modèles : vérification de la provenance, de la licence, de l'intégrité et de la version ; téléchargements et mises à jour contrôlés.
- Résultats et outils : les sorties du modèle sont traitées comme non fiables et validées. Les outils métier appliquent eux-mêmes les droits et le moindre privilège, et les actions sensibles exigent une approbation humaine.
- Observabilité : journaliser les métadonnées utiles (fonctionnalité, modèle, version, tokens, latence, décision de routage) sans enregistrer systématiquement le contenu brut des échanges sensibles.
Les embeddings, les caches et les historiques peuvent révéler des informations sensibles au même titre que les documents d'origine ; l'OWASP décrit ces formes de divulgation de données sensibles, y compris via un système RAG. Les documents injectés dans le contexte peuvent aussi porter des instructions malveillantes : c'est l'injection de prompt indirecte, pour laquelle l'OWASP considère la limitation des privilèges du modèle comme le contrôle le plus efficace.
Sur les postes Windows, Windows ML montre ce que ces contrôles deviennent pour l'inférence embarquée. Ce framework, fondé sur ONNX Runtime, exécute les modèles directement sur l'appareil et accélère l'inférence sur le NPU, le GPU ou le CPU grâce à des fournisseurs d'exécution que Windows installe et tient à jour. Les données restent sur le poste et le traitement fonctionne sans connexion. Le modèle peut être intégré au package de l'application ou téléchargé séparément ; dans les deux cas, il faut contrôler sa provenance, son intégrité et sa version, et déployer l'application avec les outils de gestion du parc, comme tout logiciel métier. Les fournisseurs d'exécution optimisés pour les NPU demandent Windows 11 24H2 ou une version ultérieure, ce qui renvoie à la question de la compatibilité du parc soulevée dans la matrice.
7. Une architecture de référence
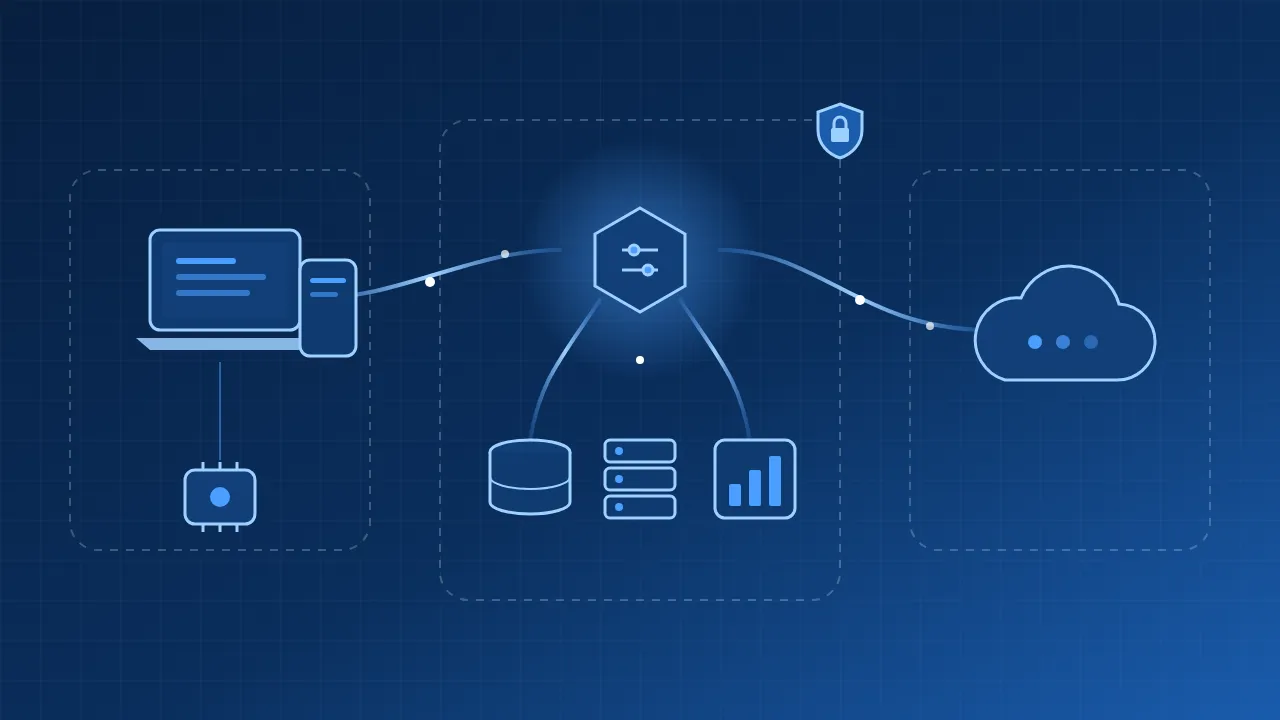
L'architecture ci-dessous combine deux parcours : l'inférence embarquée sur le terminal, et le traitement distant via une API sécurisée. Les cadres délimitent des périmètres de confiance, dont la sécurité dépend des contrôles décrits plus haut.
Version texte du schéma
- Terminal utilisateur : l'application web ou mobile peut appeler un modèle embarqué, si l'appareil est compatible. Le hors-ligne suppose que modèle, données et outils sont présents sur l'appareil.
- Environnement applicatif contrôlé : l'application appelle en HTTPS authentifié une API sécurisée (identité, autorisations, quotas), qui transmet à l'orchestration (politiques, budgets, routage, versions, repli). L'orchestration s'appuie sur les données et la recherche avec droits appliqués, l'inférence privée avec modèles approuvés et des mesures minimisées de qualité et de coût.
- Fournisseurs approuvés : l'orchestration peut appeler une API d'inférence cloud, en TLS avec identité de service, en ne transmettant que le contexte minimal autorisé. Les clés cloud ne sont jamais embarquées dans le client.
La couche d'orchestration applique les politiques de données, les budgets et les quotas, choisit le modèle et sa version, fixe les délais et définit le comportement en cas d'indisponibilité. Le Centre d'architecture Microsoft décrit ce rôle sous la forme d'une passerelle placée devant les modèles : authentification fédérée, limitation de débit, suivi de la consommation par client, cache et répartition de charge. Le même document rappelle qu'une passerelle voit passer les requêtes et réponses brutes, qu'elle élargit la surface d'attaque et qu'elle entre donc elle-même dans le périmètre de conformité.
Sur le schéma, le modèle embarqué reste sur le terminal ; ce n'est pas un service central appelé à distance. Les clés d'accès aux API cloud restent côté serveur et ne sont jamais embarquées dans l'application cliente.
8. Déployer progressivement, mesurer, réévaluer
Nous recommandons de déployer cas d'usage par cas d'usage, en sept étapes.
- Choisir un cas d'usage au volume et à la valeur identifiés, avec un responsable métier.
- Constituer un jeu d'évaluation représentatif : cas courants, cas limites, réponses attendues.
- Classifier les données et définir les destinations de traitement autorisées.
- Mesurer les options local, privé et cloud sur ce jeu : qualité, latence, coût par tâche validée.
- Déployer progressivement, par population d'utilisateurs ou par part de trafic.
- Surveiller qualité et coût en continu, avec les indicateurs décrits plus haut.
- Réévaluer après chaque changement de modèle, de version, de stratégie de routage ou de tarif.
Vous préparez un cas d'usage IA dans une application ?
Échangeons sur vos cas d'usage, vos contraintes de données et la façon de mesurer qualité et coût avant de généraliser.
Planifier un échangeSources
- EMAZIS, IA hybride en entreprise : Cloud vs. Local, le faux débat
- ONNX Runtime : Web (onnxruntime.ai)
- ONNX Runtime : Mobile, Android et iOS (onnxruntime.ai)
- Microsoft Azure Architecture Center : Passerelle devant les modèles de langage
- Microsoft Learn : Optimiser le coût des charges de travail IA
- OWASP GenAI Security Project : Prompt injection
- OWASP GenAI Security Project : Sensitive data exposure
- Microsoft Learn : Qu'est-ce que Windows ML ?
Sources consultées le 10 novembre 2026. L'exemple de répartition des demandes est hypothétique.